veilletech.fr
2 nov.

Source · 73 jours de veille

vLLM

Ce qui a été retenu de cette source, et sur quels thèmes. Chaque fiche est une synthèse originale et renvoie à l'article d'origine.

7fiches
7jours sur 73
22min de lecture
IA & LLMthème

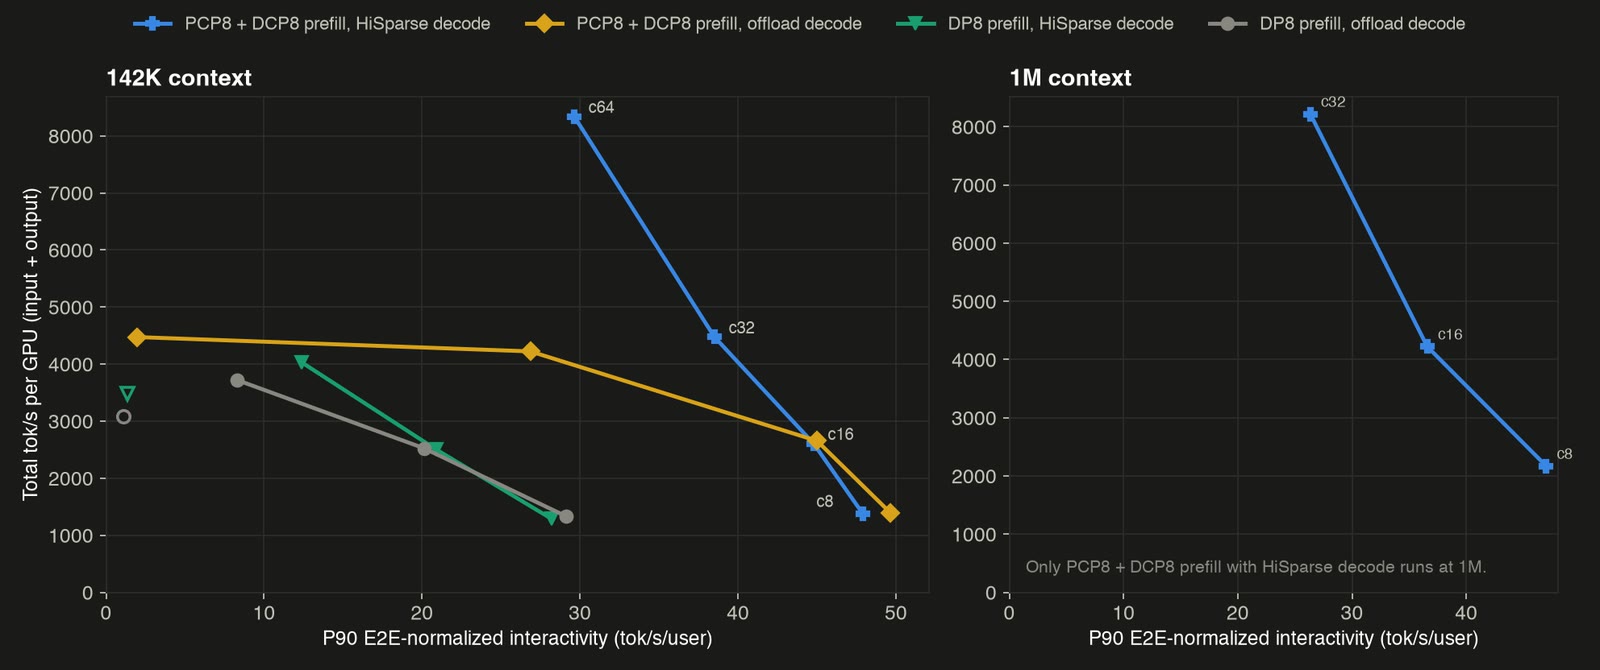
vLLM sert GLM-5.3 en contexte 1M sur 16 H200

L'équipe vLLM décrit comment servir GLM-5.3 sur 16 H200 avec des contextes jusqu'à 1 million de jetons : prefill réparti par jetons (PCP), cache KV réparti à son tour (DCP), decode avec KV en mémoire de l'hôte. Sur le benchmark AgentX, la vitesse par utilisateur est de 1,7 à 3,2 fois celle d'un déploiement en parallélisme de données, au même débit.
24 oct.3 min

LLM

vLLM sert Flint (40B MoE) sur un seul GPU, dès J0

vLLM prend en charge Flint dès sa sortie, un modèle de 40 milliards de paramètres à experts (2,5 milliards actifs) proposé en NVFP4 et en BF16 sur un seul GPU. Des noyaux dédiés aux petits lots portent le décodage à environ 500 tokens par seconde sur un GB200. Les noyaux ne ciblent qu'un seul GPU Blackwell ; ailleurs, retour aux couches standard.

22 oct.3 min

IA

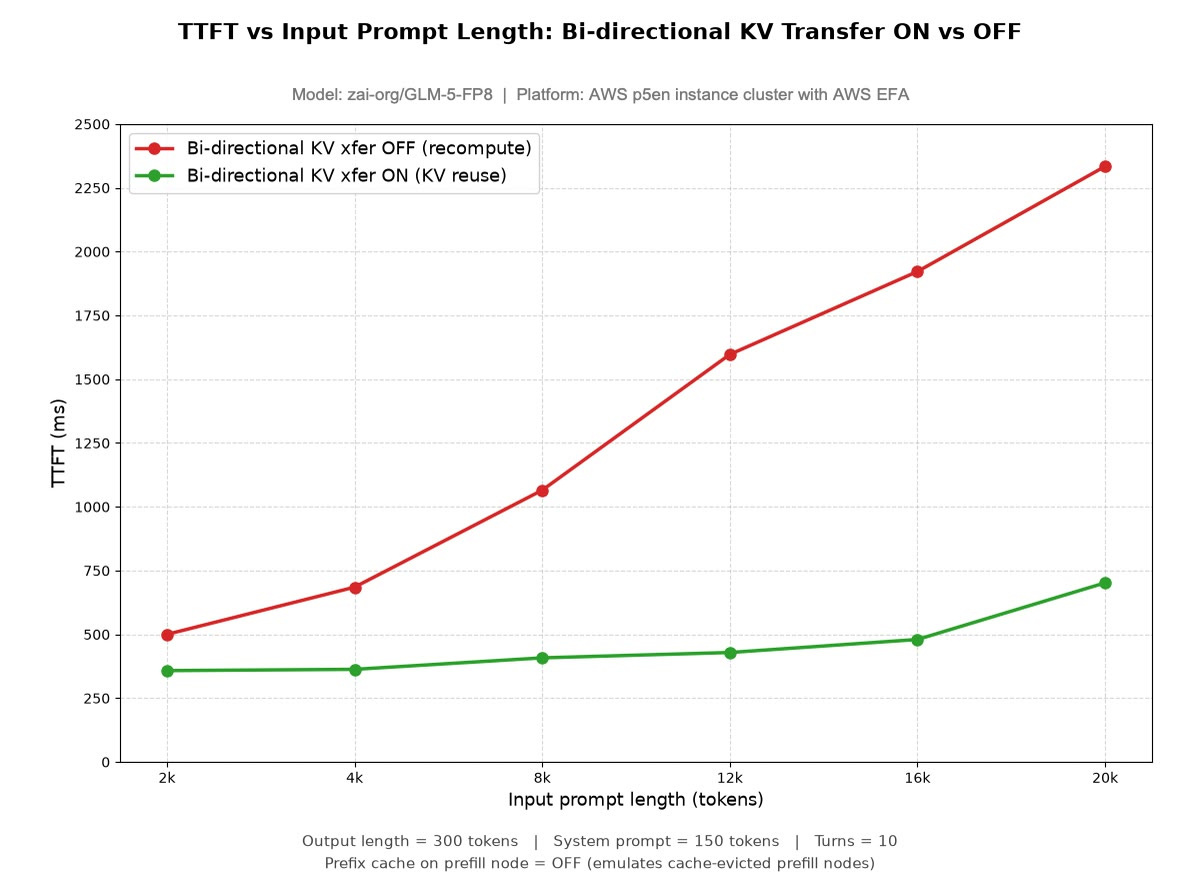
vLLM : le cache KV remonte du décodeur au prefill

vLLM ajoute un transfert bidirectionnel du cache KV : en déploiement prefill/decode, le nœud de decode garde ses blocs après la réponse et le prefill du tour suivant les relit au lieu de recalculer l'historique. Sur une paire d'instances p5en d'Amazon, le temps avant le premier jeton baisse jusqu'à 1,6× pour Qwen3-32B et 3,3× pour GLM-5-FP8, aux prompts les plus longs, prefix caching coupé sur le prefill.

13 oct.3 min

LLM

vLLM tatoue le texte sans changer la distribution

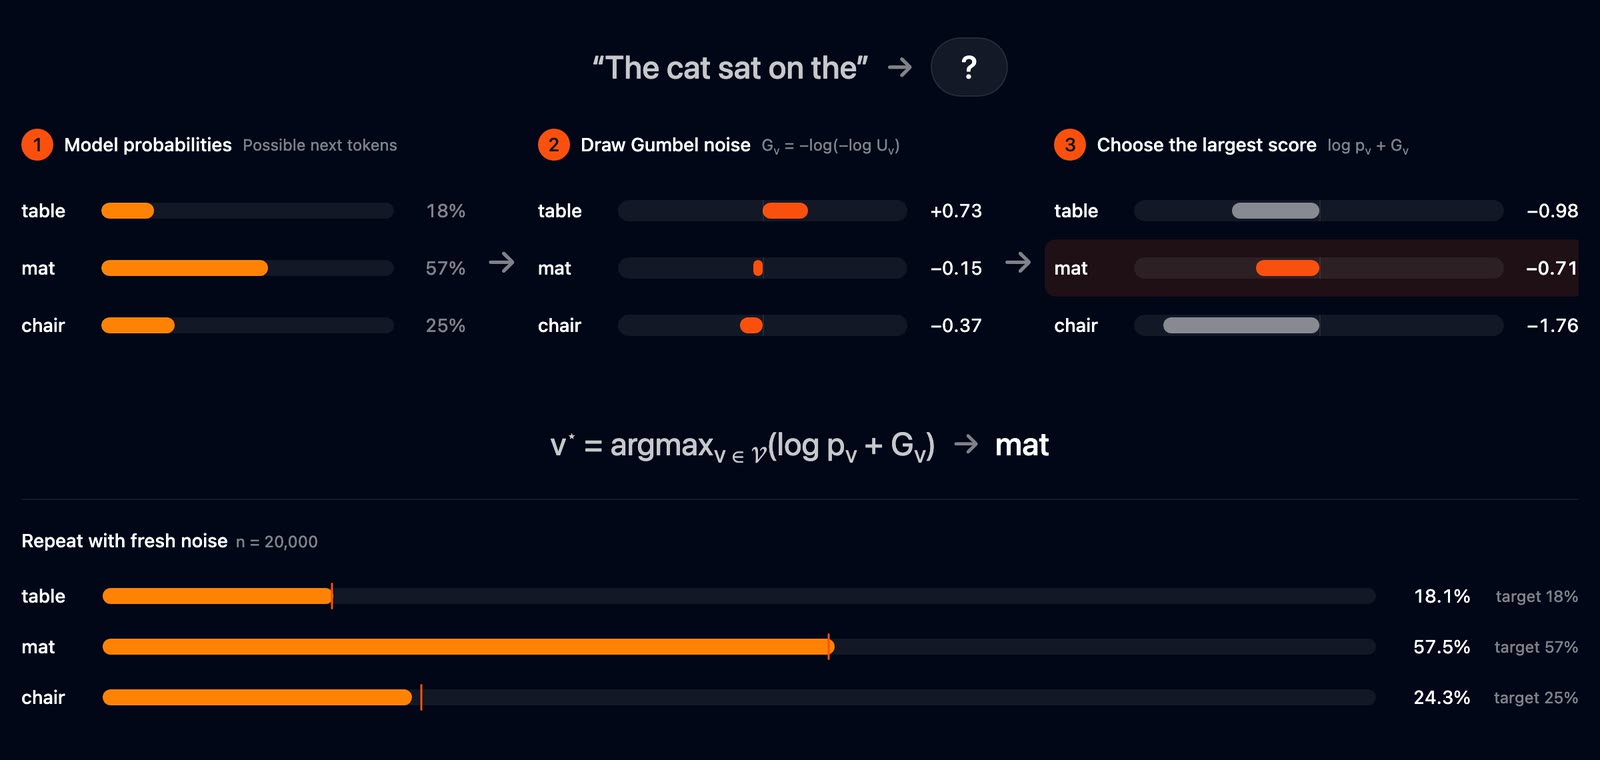
vLLM sait tatouer les textes générés avec la méthode Gumbel-max : le tirage de chaque token devient pseudo-aléatoire, dérivé d'une clé secrète et du contexte, sans changer la distribution de sortie. La détection ne demande que la clé et le tokenizer ; le surcoût mesuré sur un H100 tient dans ±2 %.

25 sept.3 min

LLM

vllm-metal : vLLM tient la charge sur un Mac

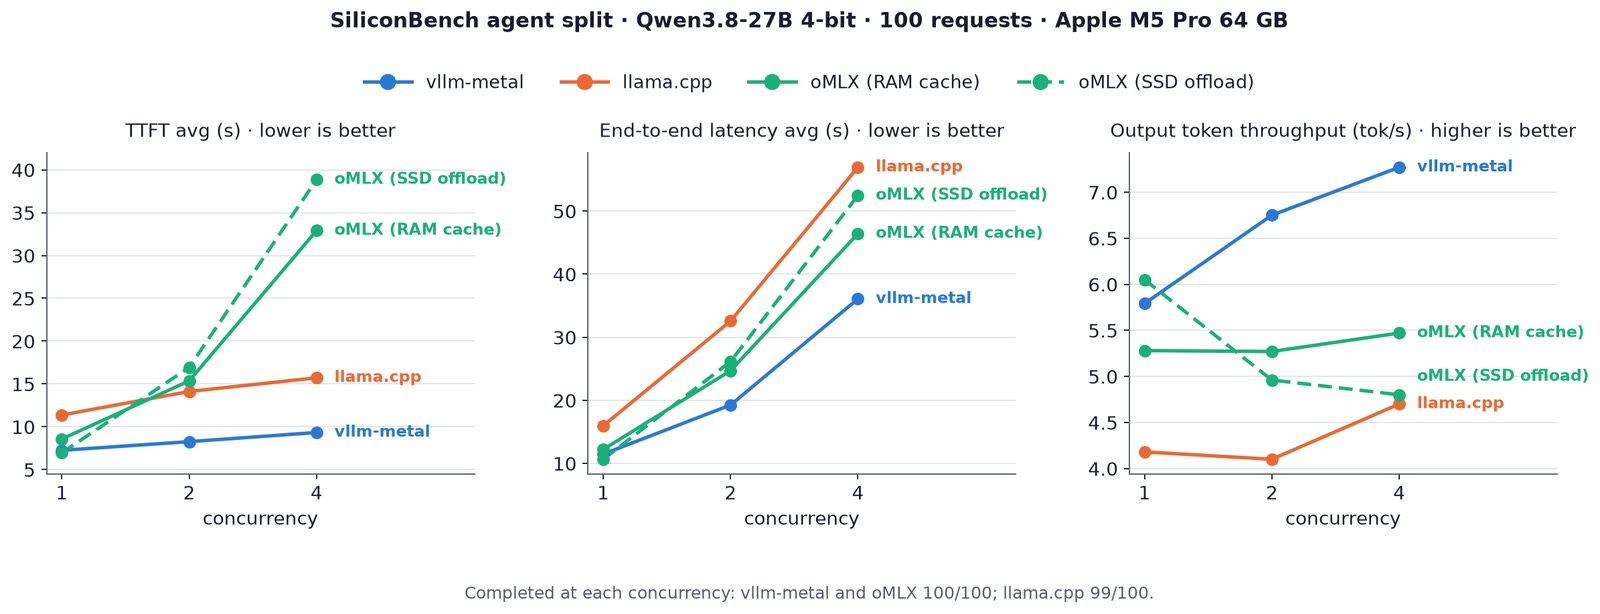
vllm-metal porte sur Apple Silicon l'ordonnanceur de vLLM, son cache KV paginé et son serveur compatible OpenAI, avec MLX et Metal pour l'exécution. Selon les mesures de l'équipe, il garde la latence la plus basse dès que plusieurs requêtes se chevauchent, là où mlx_lm s'effondre sur des lots inégaux. La v0.29.0 s'installe avec Homebrew.

24 sept.3 min

LLM

vLLM étage son cache KV jusqu'au disque et au S3

vLLM détaille son framework d'offloading étagé du cache KV : les blocs évincés du GPU passent par la RAM hôte puis vers un système de fichiers, un stockage objet S3 ou un pair distant en RDMA, au lieu d'être recalculés. Sur Qwen3.6-35B-A3B et deux H100, le niveau disque fait plus que doubler le débit au-delà de 128 conversations concurrentes.

11 sept.3 min

LLM

Un contexte d'un million sur huit H200

vLLM introduit Hybrid HiSparse, une politique de résidence du cache KV qui exploite l'attention creuse de GLM 5.3 : l'indexeur ne retient que les top-K jetons, tout le reste part en mémoire hôte, ce qui borne la mémoire GPU par requête. Le cache reste sur la carte tant qu'il y a de la place et ne bascule qu'en cas de pression. Sur un nœud de 8× H200, cela rend possible le contexte plein d'un million de jetons, jusque-là hors d'atteinte.

8 sept.4 min

LLM