veilletech.fr
18 sept.

Source · 31 jours de veille

NVIDIA Developer

Ce qui a été retenu de cette source, et sur quels thèmes. Chaque fiche est une synthèse originale et renvoie à l'article d'origine.

4fiches
4jours sur 31
12min de lecture
IA & LLM · Langages & OSthèmes

Dense ou MoE : ce que ça change à servir

NVIDIA publie un comparatif chiffré entre modèles denses et Mixture-of-Experts, du point de vue de celui qui sert le modèle. Le point central : le MoE découple la mémoire du calcul — la VRAM suit les paramètres totaux, le calcul ne suit que les paramètres actifs. À taille totale égale (~30 B, ~60 Go en BF16), Nemotron 3.5 Lightning (3 B actifs) débite 235,7 à 494,2 tokens par seconde contre 36,9 à 222,4 pour Gemma 4 31B dense, mais score 24 contre 30 à l'indice d'intelligence d'Artificial Analysis.
16 sept.4 min

IA

NVIDIA ouvre deux voies pour CUDA en Rust

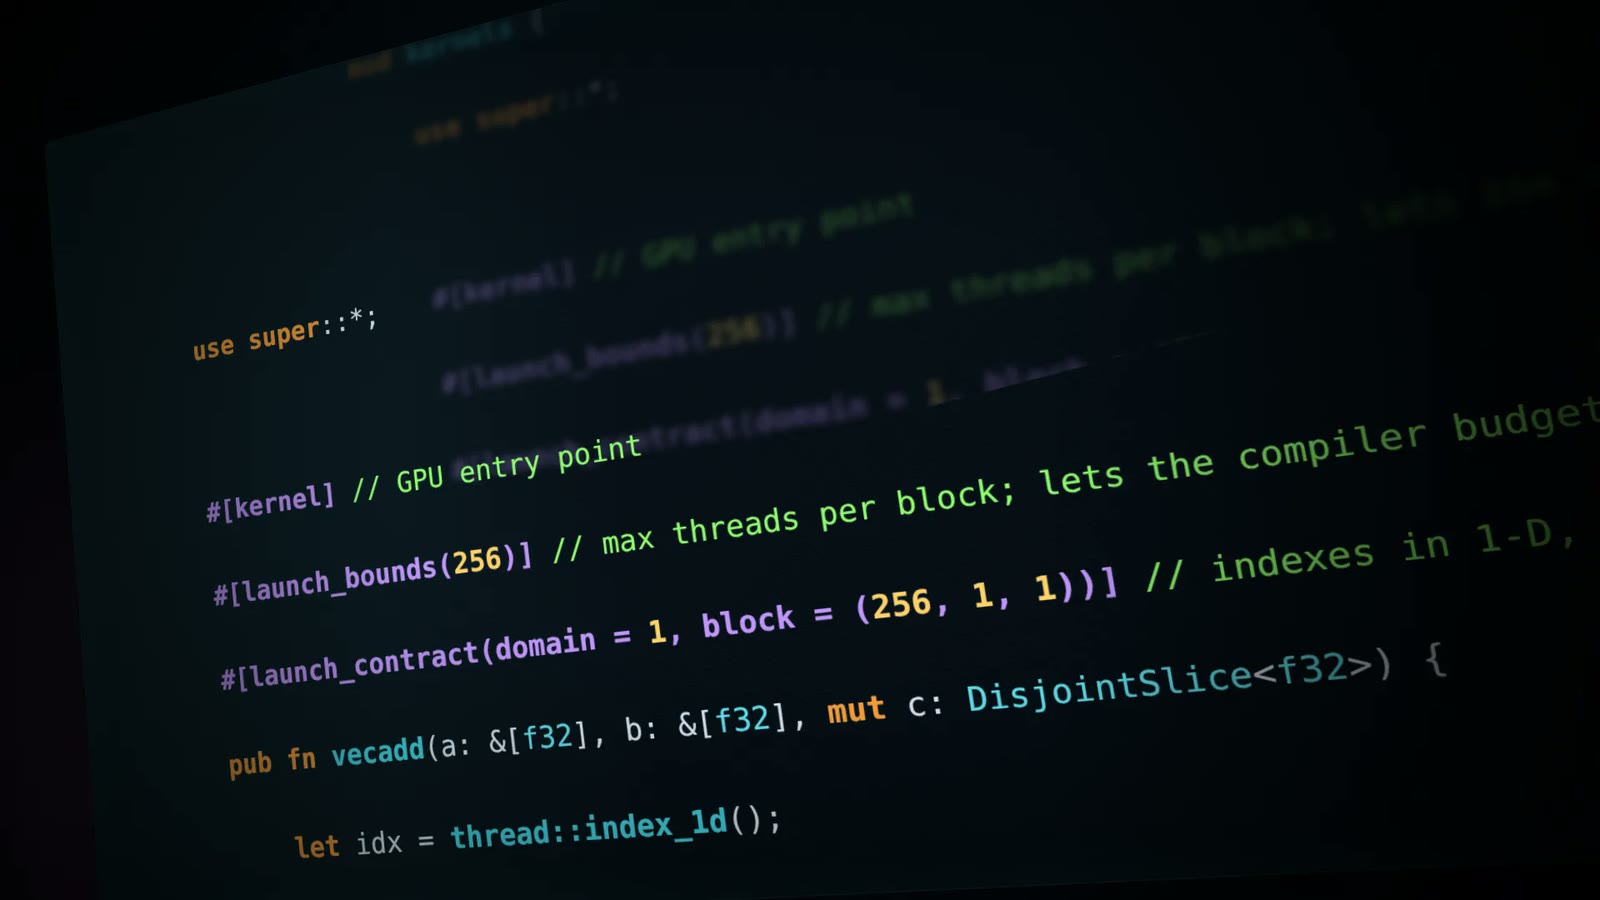
NVIDIA ouvre deux projets pour écrire des kernels GPU directement en Rust, compilés en PTX plutôt qu'enveloppés autour de code écrit ailleurs : cuda-oxide pour le modèle SIMT et cutile-rs pour le modèle Tile. L'apport n'est pas syntaxique : le compilateur refuse à la compilation l'aliasing entre le tampon de sortie d'un kernel et ses entrées. Les deux projets sont précoces — cuda-oxide en alpha exige une nightly épinglée, cutile-rs tourne sur Rust stable et est déjà utilisé en dehors de NVIDIA.

9 sept.3 min

RUST

Répartir l'inférence sur vos autres machines

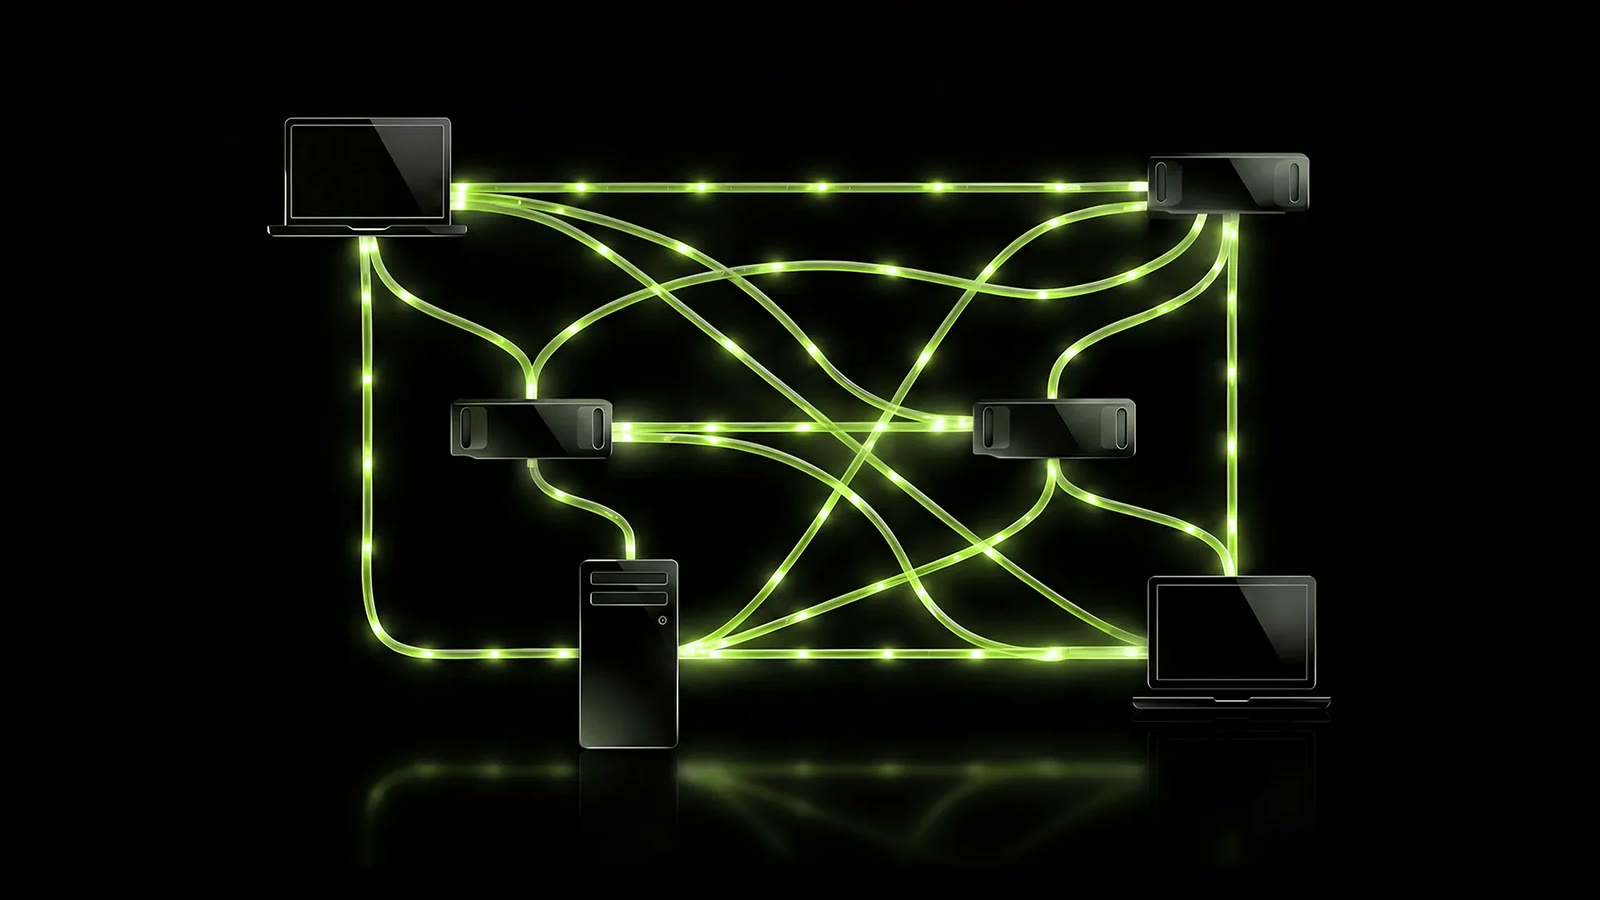
NVIDIA publie PAIR, un routeur d'inférence qui distribue les requêtes d'un agent sur les machines du réseau local sans rien changer à l'agent : il se substitue à Ollama ou LM Studio sur leur port par défaut et choisit un nœud appairé disposant du modèle demandé. Démonstration : cinq sous-agents en 18 minutes sur un portable, 8 min 48 s sur trois machines.

4 sept.3 min

LLM

Deux commandes du checkpoint à l'inférence C++

NVIDIA publie TensorRT Model Connect, une collection ouverte d'implémentations de référence pour passer d'un identifiant Hugging Face à de l'inférence C++ native. Une commande Python construit un bundle contenant les moteurs TensorRT, que l'application C++ charge ensuite sans PyTorch ni interpréteur Python à l'exécution.

29 août2 min

IA