veilletech.fr
2 nov.

Source · 73 jours de veille

GitHub

Ce qui a été retenu de cette source, et sur quels thèmes. Chaque fiche est une synthèse originale et renvoie à l'article d'origine.

20fiches
18jours sur 73
46min de lecture
Sécurité · IA & LLM · Web & Front · Outils & méthode · Langages & OSthèmes

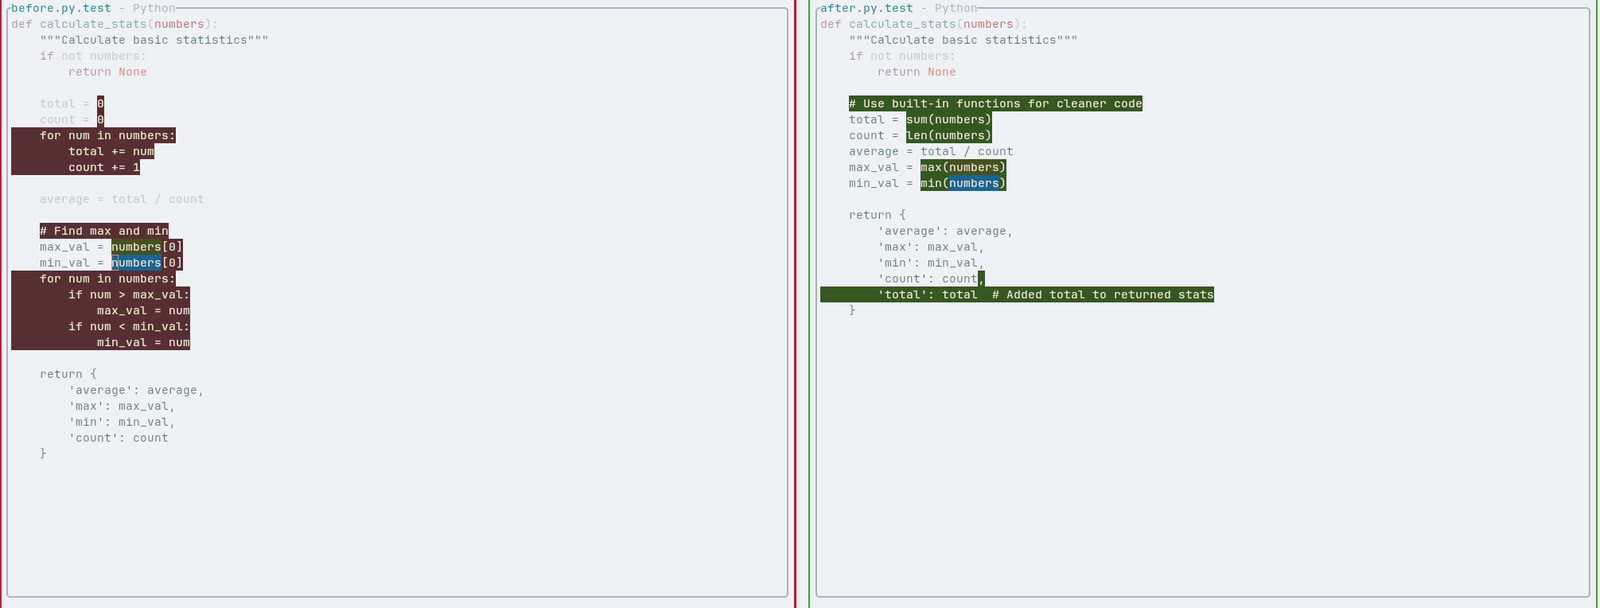
OmniDiff : un diff qui lit aussi PDF, polices, images

OmniDiff compare le code par structure et les fichiers binaires selon ce qu'ils contiennent : pixels, glyphes, pages, membres d'archive. Il se branche sur Git et Jujutsu et reste rapide sur 2 302 cas de test. Son auteur publie aussi ce qui manque : la précision visée n'est pas encore atteinte.
2 nov.2 min

OUTILS

Memdoor : cinq petits modèles, 10 problèmes, 35,79 $

Un workflow Memdoor de huit fichiers YAML fait collaborer cinq rôles sur Qwen3.8-27B, sans autre mémoire que des fichiers, et résout 9,8 problèmes sur 10 en moyenne sur un petit extrait de LiveCodeBench Hard. Le dépôt ne revendique qu'une parité avec le harnais d'origine, sur un petit échantillon et via OpenRouter. La méthode est publiée et reproductible, y compris en local.

1 nov.2 min

IA

Pico CSS s'arrête : la 2.1.1 est la dernière

Pico CSS annonce que la 2.1.1 est sa dernière version et archive ses dépôts. Le projet estime qu'une IA génère désormais du HTML léger et accessible, et qu'une réécriture en CSS moderne serait un autre projet. Rien ne casse : npm, jsDelivr et le site restent en ligne.

30 oct.1 min

FRONT

gpu-unlock : BF16 jusqu'à +81 % sur les RTX série 30

Un module noyau Linux sous GPL, gpu-unlock, lève la limite de débit des instructions FP16 et BF16 sur les cartes Nvidia GA102, GA103, GA104 et GA106 (RTX série 30) avant que le pilote ne les prenne. Sur une 3090 Ti, le BF16 passe de 87,5 à 157,4 TFLOPS ; le prefill d'un LLM gagne 14 à 36 % selon les rapports d'utilisateurs, le décodage ne bouge pas.

25 oct.3 min

LLM

DeepSeek ouvre DeepInfer, son moteur d'inférence

DeepSeek publie sous Apache 2.0 DeepInfer, le moteur d'inférence de ses services en production, limité pour l'instant à DeepSeek-V4.1-Flash et à l'inférence hors ligne. Il demande des GPU NVIDIA SM100 ou des NPU Huawei Ascend 950, et ne fournit ni cache KV ni répartition de charge. L'intérêt pour un développeur est de lire comment il règle l'invariance au lot, l'échantillonnage déterministe et les sorties structurées.

21 oct.2 min

LLM

Codex CLI 0.157 lance un démon sans demander

Depuis Codex CLI 0.157.0, ouvrir une session interactive lance un démon persistant qui copie environ 374 Mo dans ~/.codex/packages/app-server-daemon, cherche des mises à jour toutes les heures et relance le serveur, sans rien demander. Un ticket GitHub, plus de 500 points sur Hacker News, réclame une activation volontaire et donne la procédure de désactivation. C'est le constat d'un utilisateur sous WSL2, pas une position d'OpenAI.

13 oct.2 min

IA

jj 0.46 : un workspace devient un vrai worktree Git

Jujutsu 0.46.0 colocalise enfin tous ses workspaces : jj workspace add crée un worktree Git, si bien que chaque workspace est visible par Git, par l'éditeur et par les hooks — de quoi faire tourner plusieurs agents en parallèle. La version exige Git 2.42.0 et durcit jj undo et jj bisect run.

9 oct.2 min

OUTILS

mold 3.0 : le linker passe de C++ à Rust

mold 3.0 est la première version du linker réécrite en Rust. Elle se veut un remplacement direct de la 2.42.1 (mêmes options, mêmes cibles, même sortie hors corrections), vérifié en recompilant tous les paquets Gentoo. Ceux qui compilent mold eux-mêmes changent d'outillage : Cargo remplace CMake, et Rust 1.95 est requis.

6 oct.2 min

RUST

Strata : un modèle de 125B sur un GPU de 12 Go

Strata fait tourner Qwen3.8-Flash-Next, un mélange d'experts de 125 milliards de paramètres, sur un PC Windows ou Linux doté d'une carte graphique de 12 Go. La carte garde les experts les plus sollicités, la RAM tous les autres, le processeur calcule en parallèle : 53 à 94 tokens par seconde mesurés par les auteurs sur une RTX 5070, au prix d'une compression à 2-3 bits.

5 oct.4 min

LLM

macOS 27 : couper Apple Intelligence et ses modèles

Sur macOS 27, Apple Intelligence n'a plus d'interrupteur unique et ses modèles restent sur le disque une fois les fonctions coupées. RemoveMacAI les désactive par un profil de configuration, supprime les modèles via le service d'Apple et bloque leur retéléchargement. Réversible, mais la complétion prédictive de Xcode et le framework Foundation Models tombent avec.

5 oct.2 min

OUTILS

SCM : fouiller ses vidéos plan par plan, en local

SCM est une application macOS qui indexe photos et vidéos en local : vecteurs CLIP ou SigLIP pour le sens, découpage des vidéos en plans, OCR et transcription Whisper cherchés mot pour mot. Une architecture reproductible, avec un arbitrage chiffré entre modèles : SigLIP-2 B/16 importe cinq à dix fois plus vite que CLIP L/14 sur processeur.

5 oct.3 min

IA

Reladraw : des diagrammes placés par des phrases

Reladraw est un langage de diagrammes où l'on énonce la position de chaque élément par rapport aux autres, sans coordonnées ni placement automatique. Le moteur en déduit la disposition la plus compacte, de façon déterministe. Il est pensé pour que les agents de code modifient un schéma en réécrivant une phrase ; version 0.8, syntaxe encore instable.

27 sept.2 min

OUTILS

WordPress 7.1.2 : un chemin, et le PHP s'exécute

Un visiteur non authentifié peut amener get_page_template() à inclure un fichier .php local de son choix, hors des dossiers du thème. Avec un thème qui porte un dossier page-* à sa racine et un serveur où pearcmd.php est exploitable, l'inclusion devient une exécution de code. WordPress 7.1.2 corrige, avec un rétroportage jusqu'à la branche 4.7.

23 sept.1 min

SÉCURITÉ

Claude Code lit AGENTS.md, et ouvre ses mods

Depuis la version 2.1.277, Claude Code lit AGENTS.md quand un projet n'a pas de CLAUDE.md. Le support est livré comme un « mod », un plugin intégré qui s'accroche aux événements du moteur et dont Anthropic publie le code : une option, instructionFiles, décide si AGENTS.md sert de repli, s'ajoute à CLAUDE.md ou reste ignoré.

19 sept.3 min

IA

CUDA sur AMD : ZLUDA tient, cuDNN manque

Un dépôt publié le 13 septembre assemble ZLUDA, le SDK HIP 6.4 d'AMD et LibTorch pour exécuter des applications CUDA sur GPU AMD sous Windows, avec un script d'installation PowerShell. La couverture s'arrête à cuBLAS, cuBLASLt, cuSPARSE et cuFFT : cuDNN, NCCL et TensorRT restent hors périmètre.

14 sept.2 min

IA

Kimi K3 tourne sur un MacBook, à 1 token/s

Le fork ARGODRIVE Deltafin fait tourner Kimi K3 — 2,8 T de paramètres MoE, 1,45 To de poids d'experts, sans aucun élagage — sur un seul MacBook Pro M5 Max de 128 Go, les experts étant lus depuis quatre SSD. Mesure du 8 septembre 2026 : 1,0015 token/s en décodage stable sur 512 tokens, mais environ 376 s avant le premier token, le préremplissage relisant huit fois les experts de chaque couche. L'enseignement le plus utile est ailleurs : la vitesse dépend de la plus lente des seize lectures par couche, pas de la bande passante cumulée.

9 sept.3 min

LLM

Apache Maka publie ses scores, pas ses promesses

Apache Maka, en incubation à l'ASF, est un harnais d'agent qui se juge sur une seule mesure : le nombre de tâches terminées et leur coût, comparé aux autres harnais sur le même modèle avec le vérificateur officiel, résultats par tâche publiés. Son principe de conception est que le journal est le runtime — chaque message, appel d'outil et décision de permission est un RuntimeEvent append-only dont l'interface et le prompt suivant ne sont que des projections. Tout reste local et le modèle est le vôtre.

5 sept.3 min

OUTILS

104 Go de modèle sur un Mac de 48 Go

slotstream est un binaire Swift qui exécute Qwen3.8-Flash-Next (125 Md de paramètres, MoE, 103,8 Go de poids en 4 bits) sur un Mac dont la mémoire ne suffit pas, en streamant les experts depuis le SSD. Environ 12 tok/s sur un M5 Pro de 48 Go, avec 32 Go de pic mémoire, et une API compatible Ollama et OpenAI.

2 sept.2 min

LLM

Un commit, une pull request, empilées

maiao ajoute une commande git review qui transforme chaque commit d'une branche en pull request distincte, empilée sur la précédente. Le suivi repose sur les Change-Id de Gerrit, stables à travers les rebases, ce qui permet à l'outil de rebaser la pile automatiquement à chaque fusion.

26 août3 min

OUTILS

Un binaire statique qui charge le pilote GPU

SoLo permet à un binaire Linux entièrement statique, lié à musl, de charger les pilotes GPU de l'hôte compilés contre la glibc — via son propre chargeur ELF et un pont d'ABI. Une preuve Vulkan de bout en bout accompagne le projet.

20 août2 min

LINUX