veilletech.fr
2 nov.

Source · 73 jours de veille

Hugging Face

Ce qui a été retenu de cette source, et sur quels thèmes. Chaque fiche est une synthèse originale et renvoie à l'article d'origine.

12fiches
12jours sur 73
35min de lecture
IA & LLM · Web & Frontthèmes

PyTorch 2.15 sur Mac : MoE jusqu'à 6,5× plus vite

L'équipe PyTorch de Hugging Face détaille les gains du backend MPS dans PyTorch 2.15 : calcul groupé des modèles à experts natif sur GPU, couches linéaires et softmax plus rapides, FP8 disponible, et un décodage vidéo qui tombe de 270 à 8 GiB de mémoire pilote. Sur un M3 Ultra, un modèle Qwen à experts passe de 9,4 à 61,3 tokens par seconde. La version était encore en candidate, avec macOS 15 et Python 3.11 requis.
21 oct.3 min

LLM

Beam : 501 milliards de paramètres sous Apache 2.0

Reflection publie Beam, un modèle ouvert (Apache 2.0) à mélange d'experts : 501 milliards de paramètres dont 23 milliards actifs par token, 1 million de tokens de contexte, en BF16, FP8 et NVFP4. vLLM le sert dès le premier jour, avec une image Docker dédiée et un brouillon DFlash2 qui atteint 708 tokens/s sur une requête.

17 oct.2 min

LLM

Muse Spark Open : 816B de paramètres, 304 Go en 2 bits

Meta publie Muse Spark Open, un modèle multimodal à poids ouverts de 816 milliards de paramètres (mélange d'experts, 42 milliards actifs) entraîné pour le code agentique, avec un million de tokens de contexte. Hugging Face détaille l'exécution : sous llama.cpp en 2 bits (Q2_K), il occupe 304 Go et sort 18 tokens par seconde sur un Mac M3 Ultra de 512 Go.

16 oct.3 min

IA

ML Intern : fine-tuner un modèle pour 1,90 $

Un ingénieur de Hugging Face a fait construire six modèles par ML Intern, l'agent d'entraînement de HuggingChat, pour 103 $ de calcul au total : un classifieur de maladies d'agrumes passé de 14,9 % à 52,8 % pour 1,90 $, ou un réécrivain de prompts de 9B distillé en 0,8B pour 16 $. Les prompts sont publiés, et leurs trois garde-fous — score de base, essai de 50 pas, plafond de dépense — valent pour tout fine-tuning.

9 oct.3 min

IA

Agents : ThinkingBox juge la base, pas la réponse

Microsoft et Hugging Face publient ThinkingBox, un banc d'essai qui note les agents sur l'état réel de la base de données après leur passage, et rejoue chaque tâche vingt fois. Sur ses 507 scénarios métier, deux tentatives ratées sur trois se terminent sans erreur visible, et quatre échecs sur cinq tiennent à la gestion des outils plutôt qu'au raisonnement.

4 oct.3 min

IA

AstaBrief : un 8B spécialisé, et le filtre qui a payé

Ai2 publie les poids et les données d'AstaBrief 8B, un Qwen3-8B affiné par SFT puis DPO pour rédiger des rapports scientifiques cités. Le résultat le plus transposable porte sur les données : parmi quatre filtres testés sur les exemples synthétiques, écarter ceux à faible densité de citations a le plus aidé, et les combinaisons plus élaborées n'ont rien ajouté. Évaluations conduites en 2025, par l'équipe elle-même.

3 oct.3 min

IA

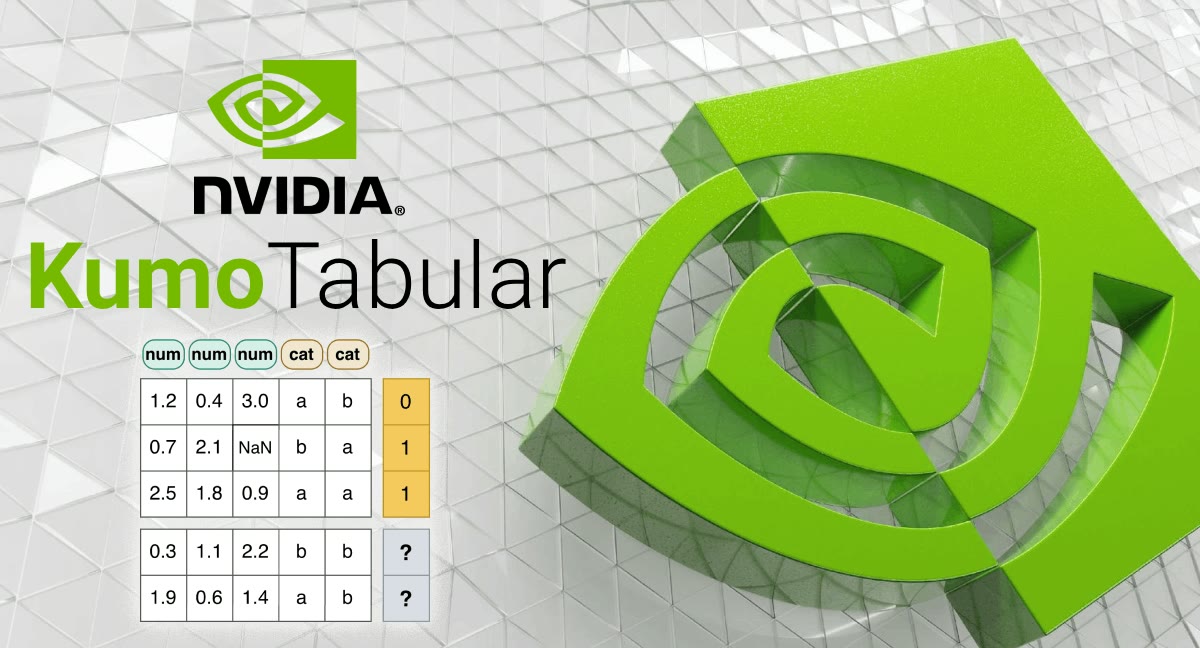
Kumo Tabular : prédire sans entraîner de modèle

NVIDIA publie Kumo Tabular, un modèle de fondation ouvert pour la classification et la régression sur tableaux : on lui donne des lignes étiquetées en contexte, il prédit les nouvelles en une passe, sans entraînement ni réglage. Trois tailles de 28 à 215 millions de paramètres, poids sur Hugging Face, licence OpenMDW-1.1 compatible avec un usage commercial. Les performances annoncées sont mesurées par NVIDIA ; la comparaison avec vos propres modèles reste à faire.

30 sept.3 min

IA

Transformers exécute vos GGUF sans les déquantifier

Transformers sait désormais exécuter des fichiers GGUF sans les déquantifier, en réutilisant les noyaux Metal de ggml distribués par la bibliothèque kernels. Le débit approche celui de llama.cpp sur un M2 Max. Le support se limite pour l'instant à Apple Silicon et à l'architecture Qwen3.5, avec transformers installé depuis main.

23 sept.3 min

LLM

Hugging Face tokenizers v1 : 3 à 30 fois plus rapide

La version candidate de tokenizers v1 encode 3 à 30 fois plus vite que la v0.23 sur un seul thread, avec des identifiants de tokens strictement identiques. Les gains viennent d'un découpage SIMD sans regex, d'un cache de mots, d'une boucle de fusion sans allocation et d'appels par lots. Seule la crate Rust est disponible ; les liaisons Python suivront pour la 1.0.0.

22 sept.3 min

IA

Votre agent a réussi. Recommencera-t-il ?

Une équipe d'IBM Research mesure l'écart entre la réussite moyenne d'un agent et sa réussite reproductible : sur AppWorld test_normal, un agent ReAct avec GPT-4.1 affiche 77,4 % en Mean@5 mais seulement 53,0 % en Pass^5, soit 24,4 points d'écart, à température 0. Leur Consistency Analyzer rejoue chaque point de décision d'une trace enregistrée pour repérer ceux qui sont à un tirage de basculer, et les consignes qui en découlent ramènent l'écart à 12,0 points.

16 sept.4 min

IA

207 kernels WebGPU pour le navigateur

Hugging Face publie @huggingface/kernels et 207 kernels WebGPU versionnés sur le Hub, chacun livré avec manifeste, tests de correction, benchmarks et shaders WGSL. Face à ONNX Runtime Web sur un M4, les kernels sont 2,57× plus rapides en moyenne géométrique sur 809 cas comparables.

2 sept.2 min

WEB

Multi-vecteur : Sentence Transformers s’y met

Sentence Transformers v6 introduit MultiVectorEncoder et toute la chaîne d'entraînement pour les modèles à interaction tardive façon ColBERT. La démonstration atteint 0,9139 de NDCG@10 sur un corpus médical, contre 0,7817 pour un modèle dense de 4 milliards de paramètres — sur une seule RTX 3090.

27 août3 min

RAG